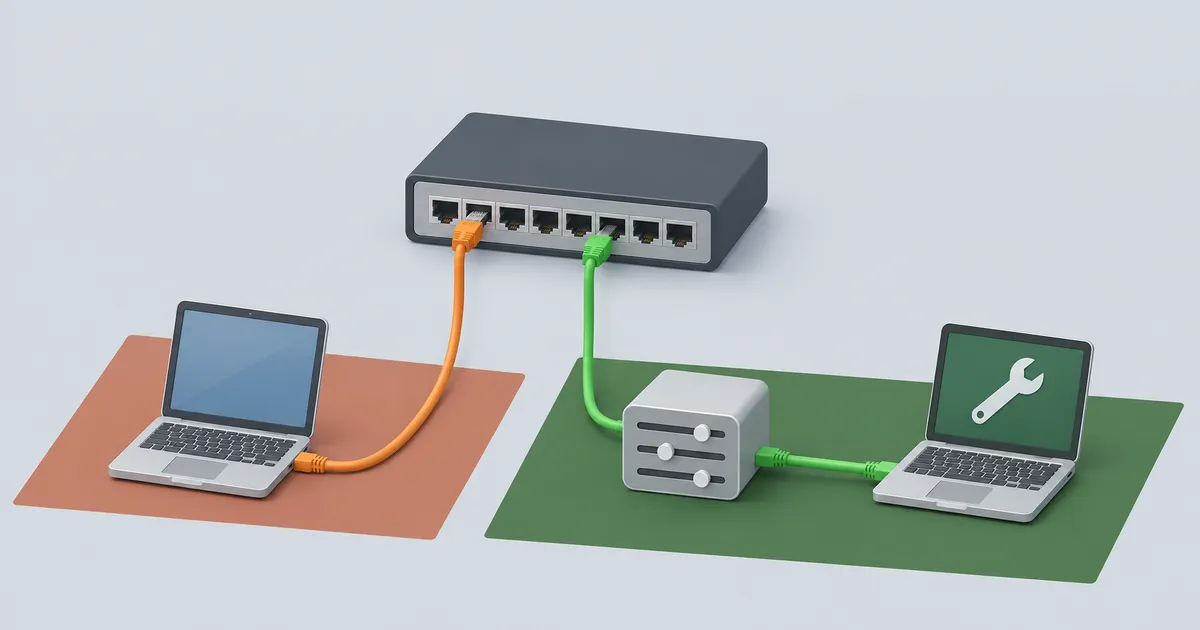
Un switch puede llevar años funcionando sin que nadie abra su panel de administración. Eso no significa que haya dejado de ejecutar software: sigue procesando tráfico, manteniendo configuración y, si es administrable, atendiendo servicios que permiten cambiar su comportamiento.
El 3 de noviembre de 2026, Zyxel publicó un aviso sobre CVE-2026-107441, una escritura fuera de límites en determinados switches GS1900. El caso sirve para revisar una idea importante: la infraestructura que transporta nuestras aplicaciones también necesita controles de acceso, actualizaciones y seguimiento. Aviso oficial de Zyxel.
Veremos qué añade la administración de un switch, cómo interpretar el aviso sin extenderlo a productos no afectados y cómo diseñar una red de gestión con acceso limitado. La guía final es independiente del fabricante: hay que adaptarla a las capacidades reales de cada equipo.
Un switch administrable incorpora una superficie de administración
Un switch Ethernet conecta dispositivos dentro de una red y reenvía tramas hacia los puertos correspondientes. Una trama es la unidad de información que circula en ese nivel de la comunicación.
Un switch no administrable ofrece normalmente un funcionamiento preconfigurado, sin un panel para definir políticas avanzadas. Un switch administrable permite consultar y modificar su configuración. Eso aporta control, pero también implica proteger los servicios que reciben esas órdenes. Diferencias entre switches administrables y no administrables, Cisco.
Según el modelo, la administración puede permitir:
- Crear VLAN y asignar puertos a distintos segmentos.
- Habilitar o deshabilitar puertos y ajustar sus parámetros.
- Configurar prioridades de tráfico, agregación de enlaces o mecanismos para evitar bucles.
- Consultar errores, contadores y eventos.
- Gestionar cuentas, certificados, copias de configuración y firmware.
No todos los equipos ofrecen las mismas funciones. Tampoco todos tienen consola, SSH, autenticación centralizada o un puerto de gestión dedicado. Antes de diseñar un control, comprueba que el modelo y su versión lo soporten.
La ausencia de una interfaz administrativa reduce una superficie concreta; no convierte a un switch no administrable en inmune a fallos ni lo hace adecuado para cualquier red.
Tres planos distintos: datos, control y gestión
La separación por planos describe funciones, no necesariamente tres procesadores o tres cables independientes:
| Plano | Función | Ejemplo en una red con switches |
|---|---|---|
| Datos | Transportar el tráfico de los dispositivos | Reenviar las tramas de un equipo hacia un servidor |
| Control | Mantener las decisiones y el estado necesarios para que la red funcione | Intercambiar información de protocolos que evitan bucles |
| Gestión | Configurar, mantener y observar los equipos | Abrir el panel HTTPS, actualizar firmware o consultar estadísticas |
Un equipo con funciones de capa 3 puede añadir protocolos de encaminamiento al plano de control. Eso no significa que todos los switches ejecuten esos protocolos. Esta clasificación ayuda a definir protecciones diferentes para el tráfico que atraviesa el dispositivo y el que termina en sus propios servicios. Principles of Secure Operations, Cisco.
Por ejemplo, permitir que una persona use una aplicación a través del switch no exige permitirle abrir su panel administrativo. Si ambos accesos quedan disponibles desde la misma red sin restricciones, se mezclan necesidades muy distintas.
Qué describe CVE-2026-107441
El aviso identifica una escritura fuera de límites en un programa CGI del firmware. CGI es un mecanismo mediante el cual un servidor web entrega una petición a un programa que la procesa. En este caso, la superficie descrita es el componente web del dispositivo.
El registro CVE indica un atacante adyacente a la red, sin privilegios previos y sin interacción de una víctima. El fabricante lo describe como un atacante desde la LAN que podría conseguir ejecución de comandos del sistema operativo mediante una petición HTTP preparada. No se requiere iniciar sesión para alcanzar el fallo descrito. Registro oficial CVE-2026-107441.
Esto no debe reinterpretarse como «cualquier persona en Internet puede explotar cualquier switch». Hay que comprobar el firmware, el modelo y la posibilidad de alcanzar el servicio afectado desde la posición del atacante. Una red interna tampoco es una frontera de confianza suficiente: puede contener un equipo de usuario comprometido.
Modelos y firmware que hay que comprobar
La tabla del fabricante enumera estos modelos. En la columna afectada, «y anteriores» se refiere a la rama correspondiente a ese modelo:
| Modelo | Versión afectada y anteriores | Versión corregida indicada |
|---|---|---|
| GS1900-8 | 2.90(AAHH.2)C0 | 2.90(AAHH.3)C0 |
| GS1900-8HP | 2.90(AAHI.2)C0 | 2.90(AAHI.3)C0 |
| GS1900-10HP | 2.90(AAZI.2)C0 | 2.90(AAZI.3)C0 |
| GS1900-16 | 2.90(AAHJ.2)C0 | 2.90(AAHJ.3)C0 |
| GS1900-24 | 2.90(AAHL.2)C0 | 2.90(AAHL.3)C0 |
| GS1900-24E | 2.90(AAHK.2)C0 | 2.90(AAHK.3)C0 |
| GS1900-24EP | 2.90(ABTO.2)C0 | 2.90(ABTO.3)C0 |
| GS1900-24HPv2 | 2.90(ABTP.2)C0 | 2.90(ABTP.3)C0 |
| GS1900-48 | 2.90(AAHN.2)C0 | 2.90(AAHN.3)C0 |
| GS1900-48HPv2 | 2.90(ABTQ.2)C0 | 2.90(ABTQ.3)C0 |
Fuente y alcance: tabla del aviso de Zyxel, consultada el 6 de noviembre de 2026. El fabricante indica que los productos en comercialización no enumerados no están afectados por este aviso. No es una declaración universal sobre equipos antiguos o cualquier otro fallo.
No basta con anotar «versión 2.90»: el identificador entre paréntesis y el nivel de parche distinguen las imágenes. Descarga la versión aprobada para el modelo y la revisión de hardware; no intercambies archivos porque su numeración se parezca.
Qué es una escritura fuera de límites
Un programa reserva regiones de memoria para almacenar datos. Si dispone de un bloque de ocho bytes, sus posiciones válidas van de 0 a 7. Intentar escribir en la posición 8 excede ese espacio.
Una out-of-bounds write ocurre cuando el programa escribe fuera del límite permitido. Puede corromper datos cercanos, provocar una caída o modificar información que interviene en el flujo de ejecución. En ciertas condiciones, esa corrupción permite ejecutar código o comandos no previstos. No toda escritura fuera de límites se convierte automáticamente en ejecución de código. CWE-787, MITRE.
La explotabilidad depende, entre otros factores, de qué datos controla el atacante, dónde se escribe, la disposición de memoria, la arquitectura y las protecciones del binario. Las defensas del compilador o del sistema pueden dificultar la explotación, pero no deben confundirse con la reparación del error.
En el caso de Zyxel, el aviso comunica el resultado potencial y el componente afectado; no publica allí todos esos detalles internos. No necesitamos inventarlos ni construir un exploit para justificar la actualización.
Además, HTTP no implica necesariamente una inyección de comandos de shell. Una petición puede ser la entrada que desencadena una corrupción de memoria. El mecanismo de la vulnerabilidad y su consecuencia son cosas diferentes.
Por qué no conviene exponer la administración
El panel, la API de configuración o el servicio de acceso remoto pueden tener errores antes o después de la autenticación. Una contraseña fuerte ayuda contra accesos indebidos por credenciales, pero no elimina un fallo previo al login.
HTTPS y TLS protegen la conexión; no corrigen el programa que procesa la petición. Tampoco hay que asumir que deshabilitar HTTP y mantener HTTPS resuelve este CVE: ambos podrían utilizar el mismo componente interno. La corrección es la actualización indicada por el fabricante.
La guía conjunta de CISA, NSA y otras agencias recomienda evitar la gestión directa desde Internet y reservarla a equipos y redes administrativos. También propone segmentación, restricciones por defecto y, cuando corresponda, una red de administración físicamente separada. Son recomendaciones defensivas, no una obligación legal general para cualquier organización. Guía conjunta de endurecimiento.
Aplicado a una pequeña empresa, esto significa evitar que el mismo portátil usado para correo y navegación tenga acceso administrativo permanente a toda la infraestructura. Un puesto administrativo o un bastión —un equipo intermedio controlado para realizar tareas de gestión— reduce esa exposición, siempre que también se mantenga protegido.
VLAN de gestión no significa administración fuera de banda
Una VLAN divide lógicamente la red de capa 2 en dominios separados. No cifra el tráfico ni decide por sí sola quién está autorizado a administrar un equipo. Si un router permite todo el tráfico entre VLAN, la separación puede no impedir llegar al panel.
Hay dos diseños que conviene distinguir:
- Gestión en banda segmentada: la administración utiliza la infraestructura de producción, pero se separa mediante una VLAN y políticas de acceso.
- Gestión fuera de banda: existe un camino de gestión separado del transporte normal de datos, por ejemplo, mediante infraestructura dedicada y las interfaces o consolas que el equipo soporte.
Una VLAN compartiendo los mismos switches no se convierte en una red físicamente independiente por llamarse «management». La guía conjunta distingue la separación lógica mediante VLAN de la gestión fuera de banda físicamente separada. Recomendaciones de arquitectura.
Un diseño de acceso sencillo
Este diagrama representa una política lógica de ejemplo. No describe los conectores físicos de un GS1900 ni presupone que tenga un puerto dedicado de administración:
No se pudo mostrar el diagrama. Puedes consultar su definición.
flowchart TB
    U["Red de usuarios · VLAN 10"] --> APP["Servicios de negocio permitidos"]
    A["Puesto administrativo dedicado"] --> F["Firewall o ACL · permitir solo lo necesario"]
    F --> M["Red de gestión · VLAN 99"]
    M --> S["Interfaz administrativa del switch"]
    U -. "Acceso administrativo denegado" .-> F
    I["Internet"] -. "Sin acceso directo a la gestión" .-> F
Una ACL, o lista de control de acceso, contiene reglas que permiten o deniegan tráfico. El punto donde se aplican importa: una regla en el router entre VLAN no filtra necesariamente dos equipos que ya están en la misma VLAN. Revisa también las restricciones de gestión del propio dispositivo y quién puede conectarse a esa red.
Los números 10 y 99 son elecciones del ejemplo, no valores especiales de seguridad. La portada representa esa separación conceptual; los colores y los cables no sustituyen una configuración.
Guía práctica de endurecimiento independiente del fabricante
La siguiente propuesta convierte los principios anteriores en un procedimiento de trabajo. No es una configuración lista para pegar: los comandos, el orden de reglas y las opciones disponibles cambian entre fabricantes y versiones.
1. Identifica qué tienes y cómo recuperarlo
Registra, como mínimo, modelo completo, revisión de hardware, firmware activo, dirección de gestión, ubicación, responsable, función, fecha de fin de soporte y fecha de la última comprobación.
Añade qué servicio depende del dispositivo y cómo acceder si pierdes conectividad. Antes de modificar la gestión, prepara una copia de configuración y un procedimiento de recuperación compatible con el equipo. Evita descubrir después del cambio que la única sesión administrativa también quedó bloqueada.
La copia puede contener secretos. Almacénala con acceso restringido y evita incorporarla a un repositorio abierto o a un ticket público. La gestión de credenciales también se aplica a contraseñas y configuraciones de infraestructura.
2. Diseña una matriz de acceso explícita
Para el diseño anterior podríamos partir de esta política:
| Origen | Destino | Acceso previsto |
|---|---|---|
| Usuarios e invitados | Interfaces administrativas | Denegado |
| Puesto administrativo autorizado | Equipo concreto | HTTPS; SSH solo si se necesita y está soportado |
| Monitorización autorizada | Equipos inventariados | Consulta SNMPv3 protegida, si se utiliza |
| Dispositivos de red | Servidores de registros y hora | Solo los destinos y protocolos necesarios |
| Internet | Interfaces administrativas | Sin acceso directo |
No conviertas la red de gestión en un segmento de confianza ilimitada. Un dispositivo comprometido no debería poder iniciar sesiones administrativas hacia todos sus vecinos. Conserva explícitamente el tráfico de control necesario: filtrar el plano de gestión no justifica bloquear a ciegas protocolos que mantienen operativa la red.
En puertos de acceso y enlaces que transportan varias VLAN, verifica asignaciones y VLAN permitidas. Retira puertos y servicios que no se utilicen después de comprobar su función. No basta con crear una VLAN si los usuarios pueden entrar en ella por un puerto mal configurado.
3. Reduce servicios y fortalece las identidades
Deshabilita interfaces de administración innecesarias y protocolos inseguros cuando exista una alternativa compatible. Prefiere HTTPS y SSH a HTTP y Telnet; para monitorización, usa SNMPv3 con autenticación y cifrado cuando esté disponible. Restringe los orígenes permitidos incluso para los protocolos cifrados. Protección del plano de gestión, Cisco.
Usa cuentas personales y permisos ajustados a cada tarea: consultar métricas no requiere cambiar VLAN ni instalar firmware. Los principios de mínimo privilegio y control de acceso son aplicables aunque el equipo solo ofrezca roles básicos.
Si el dispositivo soporta autenticación centralizada, comprueba sus capacidades y su comportamiento cuando el servidor de identidad falla. Mantén una cuenta de emergencia restringida, custodiada y auditable; no una contraseña común para toda la flota.
Cuando no haya MFA nativo, puede incorporarse en el acceso al bastión o a la plataforma administrativa. Eso protege ese recorrido, pero no añade MFA al servicio del switch ni neutraliza una vulnerabilidad alcanzable desde otra ruta.
4. Gestiona el firmware como un cambio verificable
La gestión de parches incluye identificar, priorizar, obtener, instalar y verificar las actualizaciones. Descargar una imagen no demuestra que el equipo haya arrancado con ella. NIST SP 800-40 Rev. 4.
Para este tipo de cambio:
- Confirma modelo, hardware, versión actual y aviso aplicable.
- Obtén el firmware desde el canal oficial y comprueba firma o hash cuando el fabricante lo proporcione. Un hash solo es útil como referencia si procede de una fuente confiable.
- Revisa requisitos de actualización, compatibilidad de configuración y procedimiento de recuperación.
- Programa la intervención según exposición y criticidad; documenta las restricciones temporales si no puedes parchear inmediatamente.
- Después del reinicio, comprueba la versión activa, acceso de gestión, VLAN, enlaces y servicios dependientes.
- Actualiza el inventario y conserva evidencia del resultado.
No presupongas que volver a una imagen vulnerable es una recuperación aceptable a largo plazo. Tampoco reintroduzcas una configuración sospechosa sin revisarla si existen indicios de compromiso.
5. Comprueba acceso permitido y acceso denegado
Desde equipos de prueba autorizados, verifica ambos sentidos de la política:
- El puesto administrativo alcanza el servicio previsto y puede autenticarse con los permisos correctos.
- Un equipo de usuarios y uno de invitados no alcanzan los servicios administrativos.
- La restricción cubre las direcciones IPv4 e IPv6 y todas las interfaces de gestión habilitadas.
- La monitorización sigue funcionando sin recibir permisos de escritura innecesarios.
- La configuración persiste después de guardar y reiniciar cuando el procedimiento del fabricante lo requiere.
Estas son comprobaciones de conectividad y autorización sobre tu propia red, no pruebas de explotación. Un ping fallido no demuestra que HTTPS esté bloqueado; verifica el servicio que realmente quieres restringir. Y que aparezca una página de login desde la red de usuarios ya demuestra alcance al componente web, aunque la contraseña sea desconocida.
6. Mantén visibilidad después del cambio
Recoge eventos de acceso, cambios de configuración, reinicios y fallos relevantes en un destino protegido cuando el dispositivo lo permita. Sincroniza la hora para relacionar eventos y define qué cambios requieren revisión. La guía conjunta destaca la necesidad de visibilidad sobre conexiones de gestión y modificaciones inesperadas. Guía de visibilidad y endurecimiento.
No confundas un enlace activo con un equipo seguro: el switch puede reenviar tráfico y tener una configuración alterada. Una caída de conectividad tampoco demuestra por sí sola un ataque. Compara configuración, firmware y eventos con un estado conocido y con los cambios autorizados.
Si sospechas compromiso, limita el acceso, conserva registros y configuración para el análisis y coordina recuperación con el fabricante o el equipo de respuesta. Instalar un parche corrige una vulnerabilidad; no demuestra que se hayan eliminado todos los efectos de una intrusión previa.
Qué hacer al llegar al fin de soporte
El fin de venta y el fin de soporte de vulnerabilidades no son necesariamente la misma fecha. Consulta la política aplicable al modelo, registra el límite real y planifica su sustitución antes de perder actualizaciones.
CISA, FBI y NCSC advierten especialmente sobre dispositivos de borde sin soporte y recomiendan reducir esa exposición y gestionar su reemplazo. La obligación estadounidense citada en esa guía tiene un ámbito federal concreto; no convierte automáticamente sus plazos en requisitos para cualquier empresa. Guía sobre dispositivos de borde sin soporte.
Para un switch interno, la decisión también debe considerar su papel y quién puede alcanzarlo. Si la sustitución no es inmediata, documenta una excepción temporal con responsable, restricciones de acceso, monitorización y fecha de retiro. El aislamiento reduce exposición, pero no produce un parche que el fabricante ya no entrega.
Al retirarlo, elimina configuración y credenciales mediante el procedimiento del fabricante, revoca los accesos asociados y actualiza el inventario. No reutilices sin revisión una copia antigua en el reemplazo.
La administración de la red también necesita límites
Un switch administrable aporta herramientas para segmentar y observar la red. Para aprovecharlas con seguridad, su propia administración debe tener límites claros: quién llega, con qué identidad, qué puede cambiar y cómo se detecta ese cambio.
El caso GS1900 muestra por qué hay que combinar actualización y reducción de exposición. La segmentación limita los caminos hacia el servicio vulnerable; el firmware corregido resuelve el fallo conocido. Ninguna de las dos medidas sustituye por completo a la otra.
Referencias
- Zyxel: aviso de CVE-2026-107441, modelos y firmware corregido.
- CVE: registro CVE-2026-107441.
- MITRE: CWE-787, Out-of-bounds Write.
- Cisco: Managed Versus Unmanaged Switches.
- Cisco: Principles of Secure Operations.
- CISA, NSA y organismos asociados: Enhanced Visibility and Hardening Guidance for Communications Infrastructure.
- NIST SP 800-40 Rev. 4: planificación de gestión de parches.
- CISA, FBI y NCSC: Reducing the Attack Surface for End-of-Support Edge Devices.
Aviso, registro y versiones consultados el 6 de noviembre de 2026. El diagrama y la matriz son propuestas didácticas; no se realizaron pruebas sobre switches reales.